GuangJian Team · Ant Group · Technical Report

Venus‑
DeFakerOne2

A Vision-Forensics Foundation Model
with Broader Coverage

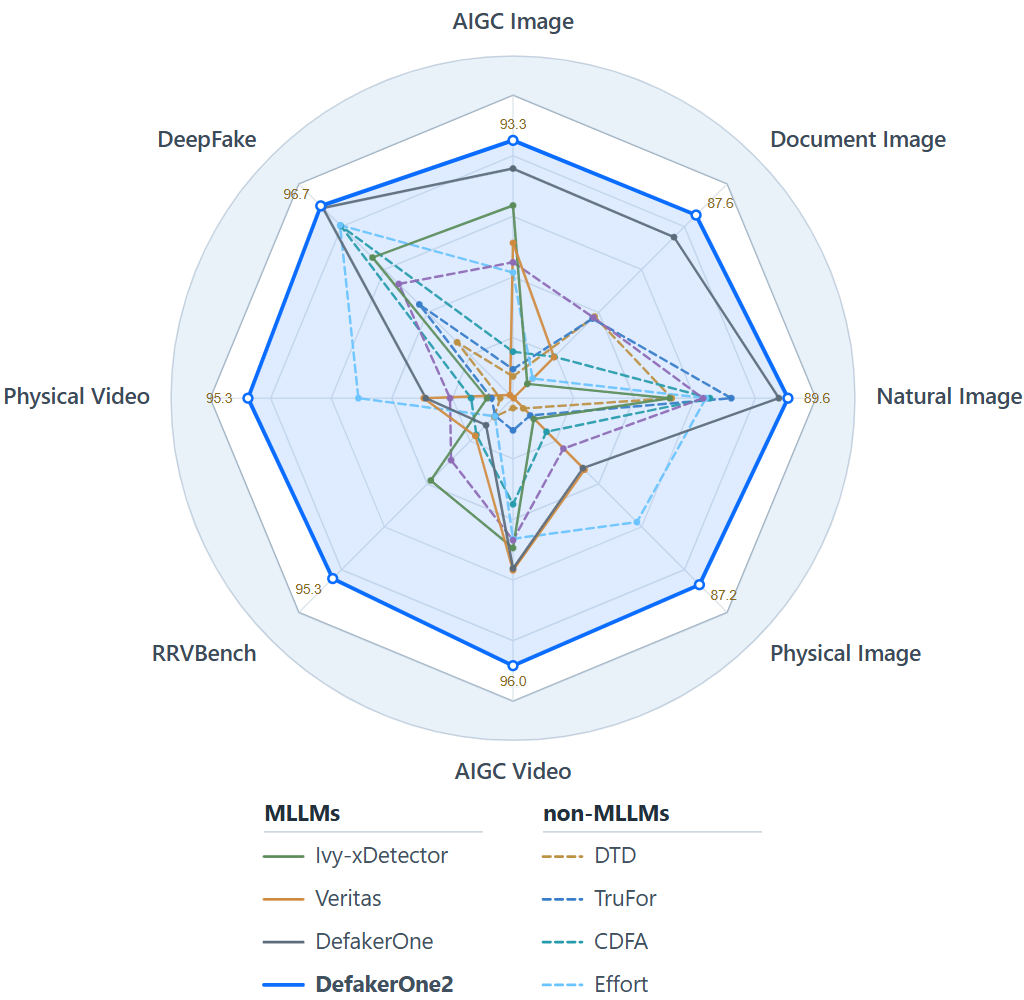
真实世界的伪造是异质的:它既以数字篡改的形式出现,也以物理翻拍/面具攻击的形式出现;既由图像承载,也由视频承载。DeFakerOne2 用一套 2B 参数同时覆盖 {digital, physical} × {image, video} 的完整矩阵,在 8 个领域全部排名第一。

DeFakerOne2是视觉防伪领域的Jev。作为首款视觉防伪System One模型,DeFakerOne2以单token这种最高效预测形式做真假二类决策,并输出可靠置信度。为防伪实际应用下游微调 提供垂域专精基座。

◆2026-09-01 ◆Qwen3.5-2B backbone ◆~50M training samples ◆53 detection + 14 localization benchmarks ◆Binary Decision
DefakerOne2: Stronger & Broader Defense Coverage — 覆盖 {digital, physical} × {image, video} 全矩阵的雷达图
0
All Four Domains
Ranked #1
0/53
Detection SOTA
(DefakerOne Family)
0/14
Localization SOTA
(DefakerOne Family)
0/53
Detection SOTA
(DefakerOne2)
0/14
Localization SOTA
(DefakerOne2)
0M
Training
Samples
0
Points Improvement
on Image Domain
v.s. DefakerOne
0
Points Improvement
on Video Domain
v.s. DefakerOne
0
Points Improvement
on Latest Image Generators
v.s. DefakerOne
0
Points Improvement
on Latest Video Generators
v.s. DefakerOne
Figure 2 — DeFakerOne2 在视觉防伪任务上取得全面领先的性能
Fig. 1 — DeFakerOne2在视觉防伪任务上取得全面领先的性能,大幅度超越上一代防伪基模DefakerOne及各领域最优专家模型。

01 — Capability Boundary

把碎片化的检测器,收敛成一个基础模型

图像数字攻击取证、图像物理攻击取证、视频数字攻击取证、视频物理攻击取证——这四个社区长期各自维护 benchmark、知识路线与模型设计。尽管核心目标完全相同:区分真实媒体与伪造媒体,却未能实现通用建模与统一。
点击下方矩阵任一格,查看该象限覆盖的任务与代表性 benchmark。

Image
Video
Forgery Form

下方展示了该象限的示例样本

Quadrant Samples · Digital × Image
Real Fake 悬停暂停
Real
Fake

02 — Method

三项核心设计

在约 5000 万条反伪造语料上训练一个统一模型,面临两个硬问题:样本难度极不均衡与理想训练方式不同;以及视频取证中的模态两难。下面三项设计分别回应。

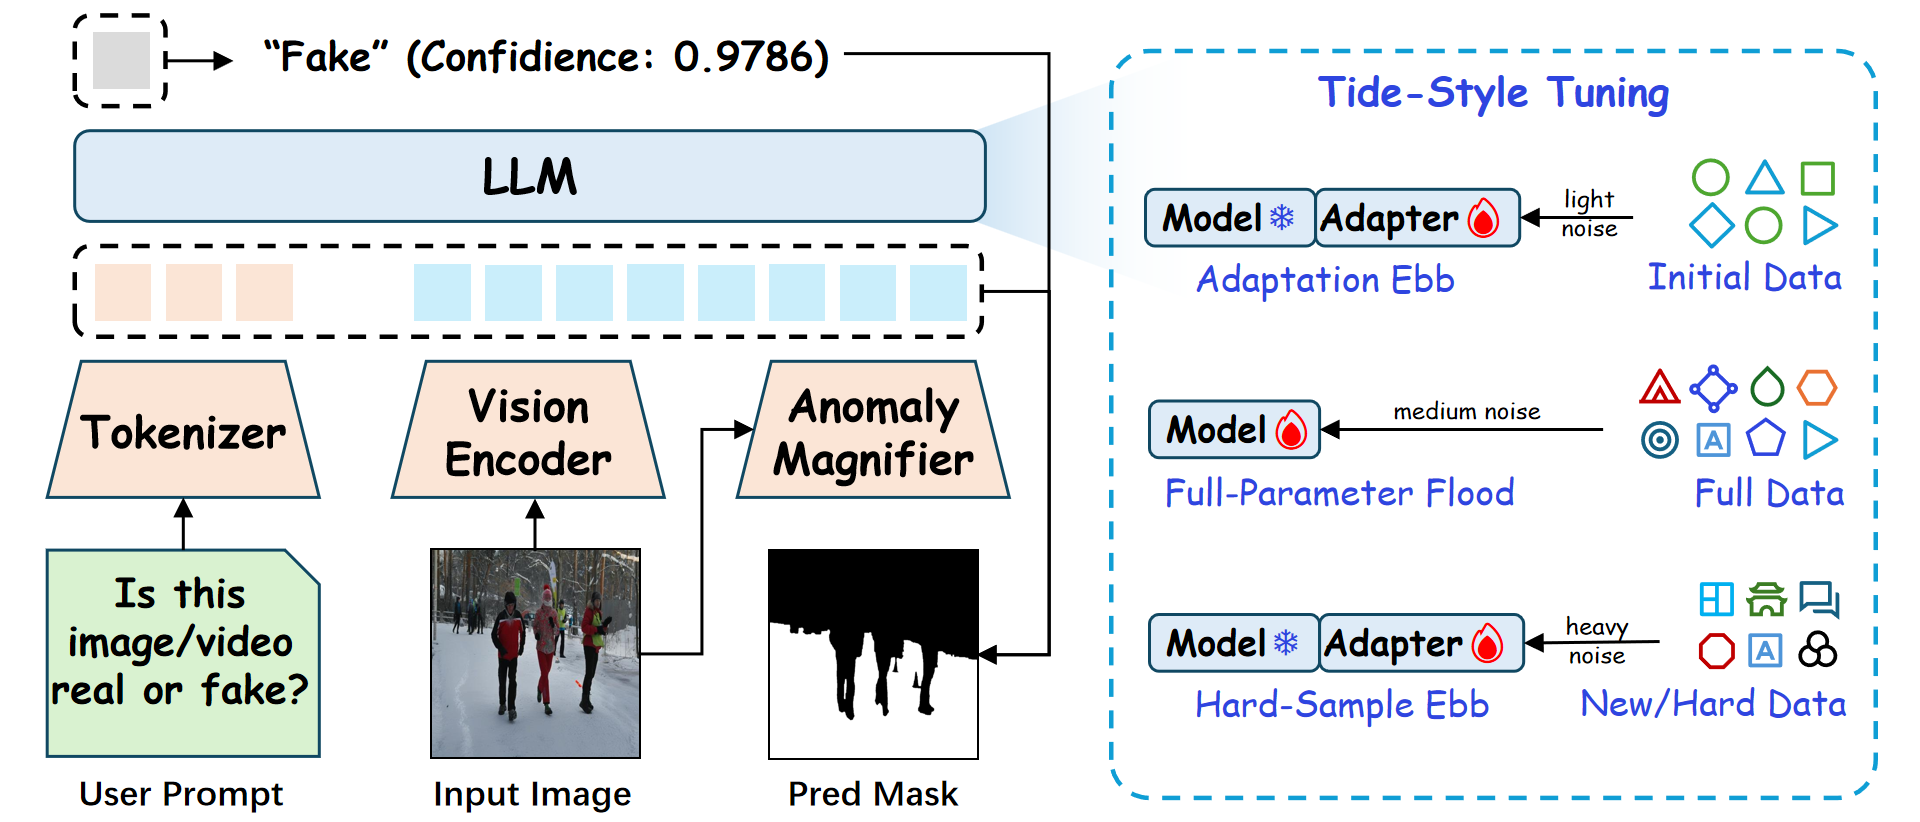
DeFakerOne2 总体框架:Vision Encoder + Anomaly Magnifier → LLM → Pred Mask Tide-Style Tuning:LoRA 退潮 → 全参涨潮 → LoRA 再退潮的三阶段训练示意
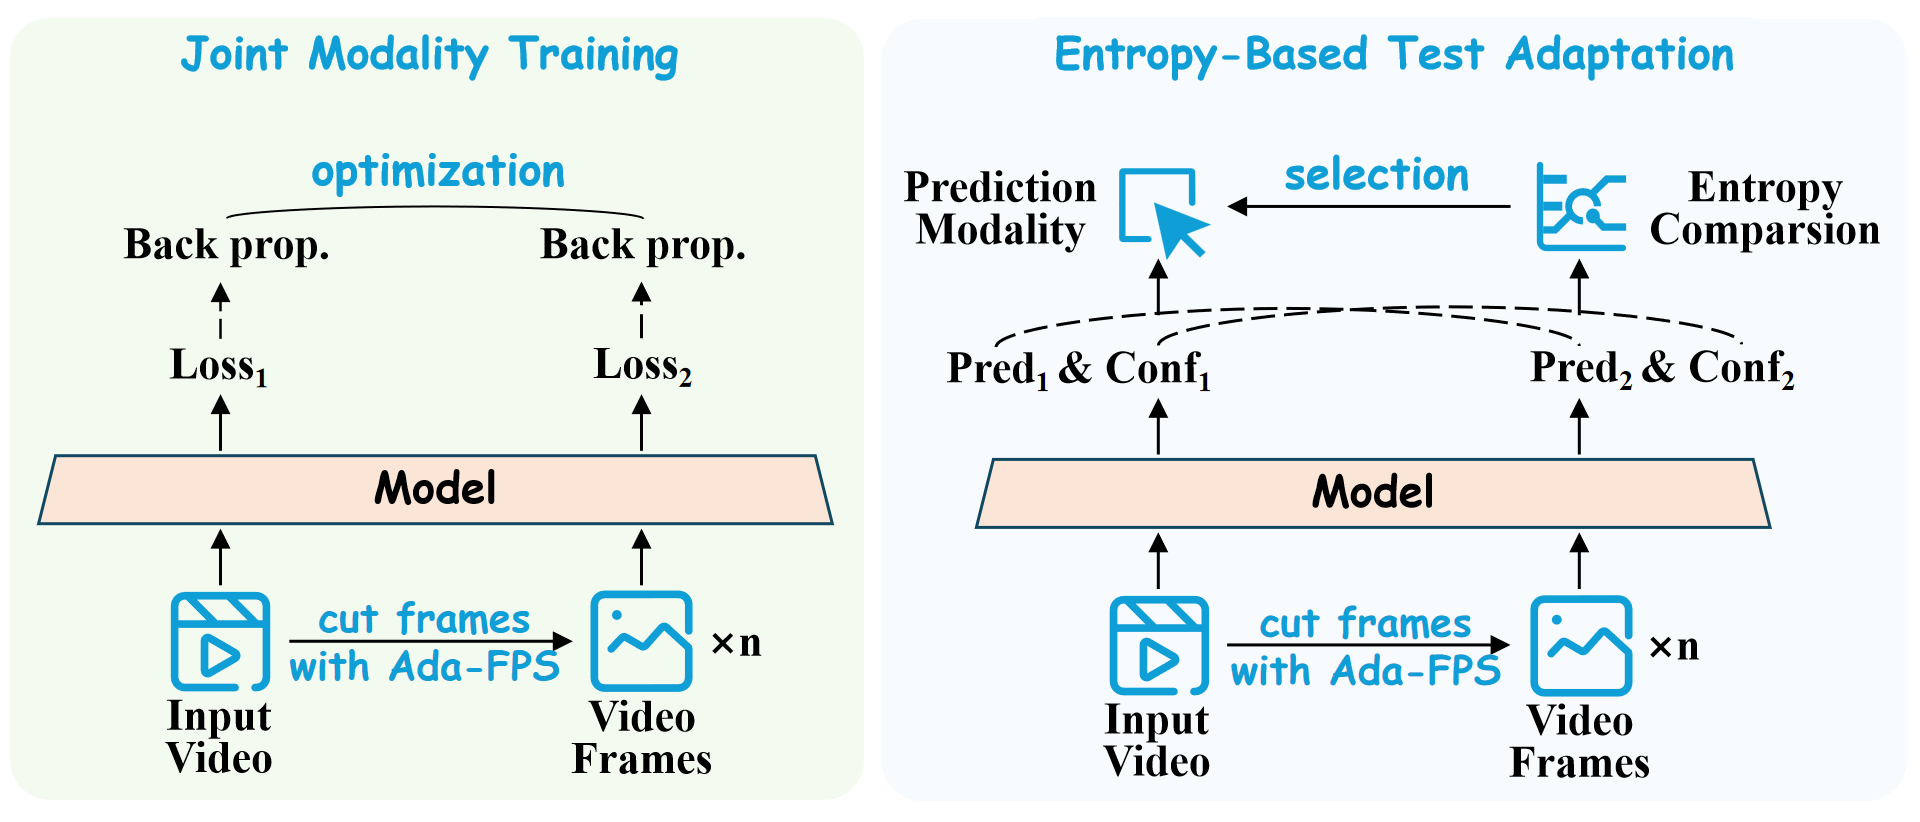
      Fig. 2 — DeFakerOne2 总体框架与潮汐微调策略 (Tide-Style Tuning)。          Fig. 3 — DeFakerOne2 的模态协同策略 (Modality Synergism)。
/ 01

Tide-Style Tuning

像潮汐一样涨落交替的三阶段训练:LoRA 退潮(低成本对齐、保留 Qwen3.5 知识与隐式逻辑分析能力)→ 全参涨潮(释放全部参数预算拟合大规模异质语料)→ LoRA 再退潮(低成本继续优化难样本和新样本,并防止在海量易样本上过拟合)。

LoRA(τ₁) → merge → Full(τ₂) → LoRA(τ₃)
noise: light → medium → heavy
data: initial → full → new/hard
/ 02

Modality Synergism

在训练侧与推理侧同时使用动态模态。训练时每个视频以「原生视频」与「自适应帧率抽取的单帧图」双模态同时训练。推理时分别以两个模态进行预测,选取预测香农熵最低的模态作为选中模态。

训练: L = L_det(clip) + L_det(frames)
共享 backbone,损失独立
推理: m* = argminm Hm,  Hm = −cm log cm − (1−cm) log(1−cm)
取熵最低香农熵模态的预测作为最终判定
/ 03

Anomaly Magnifier + Calibration Loop

以 DINOMAC 为辅助编码器强化细粒度线索感知,提供更加准确的伪造像素定位能力。并用全局判定 p 动态推导像素预测的二值化阈值 τ(p),让定位决策边界基于全局证据校准。同时减少: 1. 真实图上的过分割假阳和 2. 伪造图上的漏检。

τ(p) = 0.75 − p/2 = ½ + ½(½ − p)
M_cal = 𝟙[ M > τ(p) ]

03 — Interactive

三个可以亲手拨动的机制

论文的三处关键设计都做成了可交互演示——拖动滑块,直接看训练相位、模态熵路由与阈值校准环如何工作。

① Tide-Style Tuning · 训练相位

拖动 → 切换相位

横轴是训练进程。LoRA 与全参微调交替进行:退潮时低成本对齐与正则化,涨潮时释放全部参数容量。注意每阶段配套的数据构成与噪声强度如何变化。

Phase 1 · Ebb
Adaptation Ebb
LoRA 微调通用预训练 Qwen3.5,适配防伪任务同时尽量保留隐式常识与逻辑辅助分析能力。
数据:Initial Data · 噪声:Light
Phase 2 · Flood
Full-Parameter Flood
LoRA 权重合并入骨干后做全参微调,释放全部参数预算拟合大规模异质伪造语料。
数据:Full Data · 噪声:Medium
Phase 3 · Ebb
Hard-Sample Ebb
回到 LoRA,作为正则项把模型导向难样本新样本,防止在海量易样本上过拟合。降低训练成本。
数据:New / Hard Data · 噪声:Heavy
12%

② Entropy-based Test Adaptation · 模态熵路由

拖动 → 改变证据分布

哪一模态承载更强证据是样本相关且先验未知的:有些伪造证据集中在时序与跨帧上下文(闪烁、运动不一致),原生视频模态更优;有些证据集中在单帧纹理,喂视频反而用冗余时序 token 稀释注意力。推理时同时取两种模态的预测,用 Shannon 熵度量确定性,采纳更确定的一方——无需额外训练,也无需学习路由模块。

Video Modality0.96
Shannon entropy H(video) · 越低越确定
pred: Fake · p=0.62
Frame Modality0.59
Shannon entropy H(frames) · 自适应帧率抽取
pred: Fake · p=0.86
26%
采纳 Frame 模态预测
H(frame)=0.59 < H(video)=0.96 → 帧序列更确定 · 证据集中在单帧纹理(文字/logo 级编辑)

③ Calibration Loop · τ(p) 动态阈值

拖动 → 改变全局判定 p

像素解码器对所有输入一视同仁,容易把真实图上「显著但无害」的区域(纹理边界、强边缘、压缩痕迹)误判为篡改。校准环把定位决策边界条件化于全局判定 p:p→1 时阈值降到 0.25,弱但真实的篡改线索不再被压制;p→0 时阈值升到 0.75,只有极显著异常才能通过。p=0.5 时退化为传统固定阈值——校准从不注入全局证据不支持的偏置。

0.88
Rejected · M ≤ τ(p)
Admissible · M > τ(p)
0.75
0.50
0.25
τ = 0.31
Decision Boundary τ(p)
τ = 0.310 · 由 p = 0.88 推导
Segmentation Policy
宽松:弱篡改线索被保留,召回优先
Calibrated Mask
Mcal = 𝟙[ M > 0.310 ]
Region Score → Final Decision
Fake · conf 0.9786

04 — Results

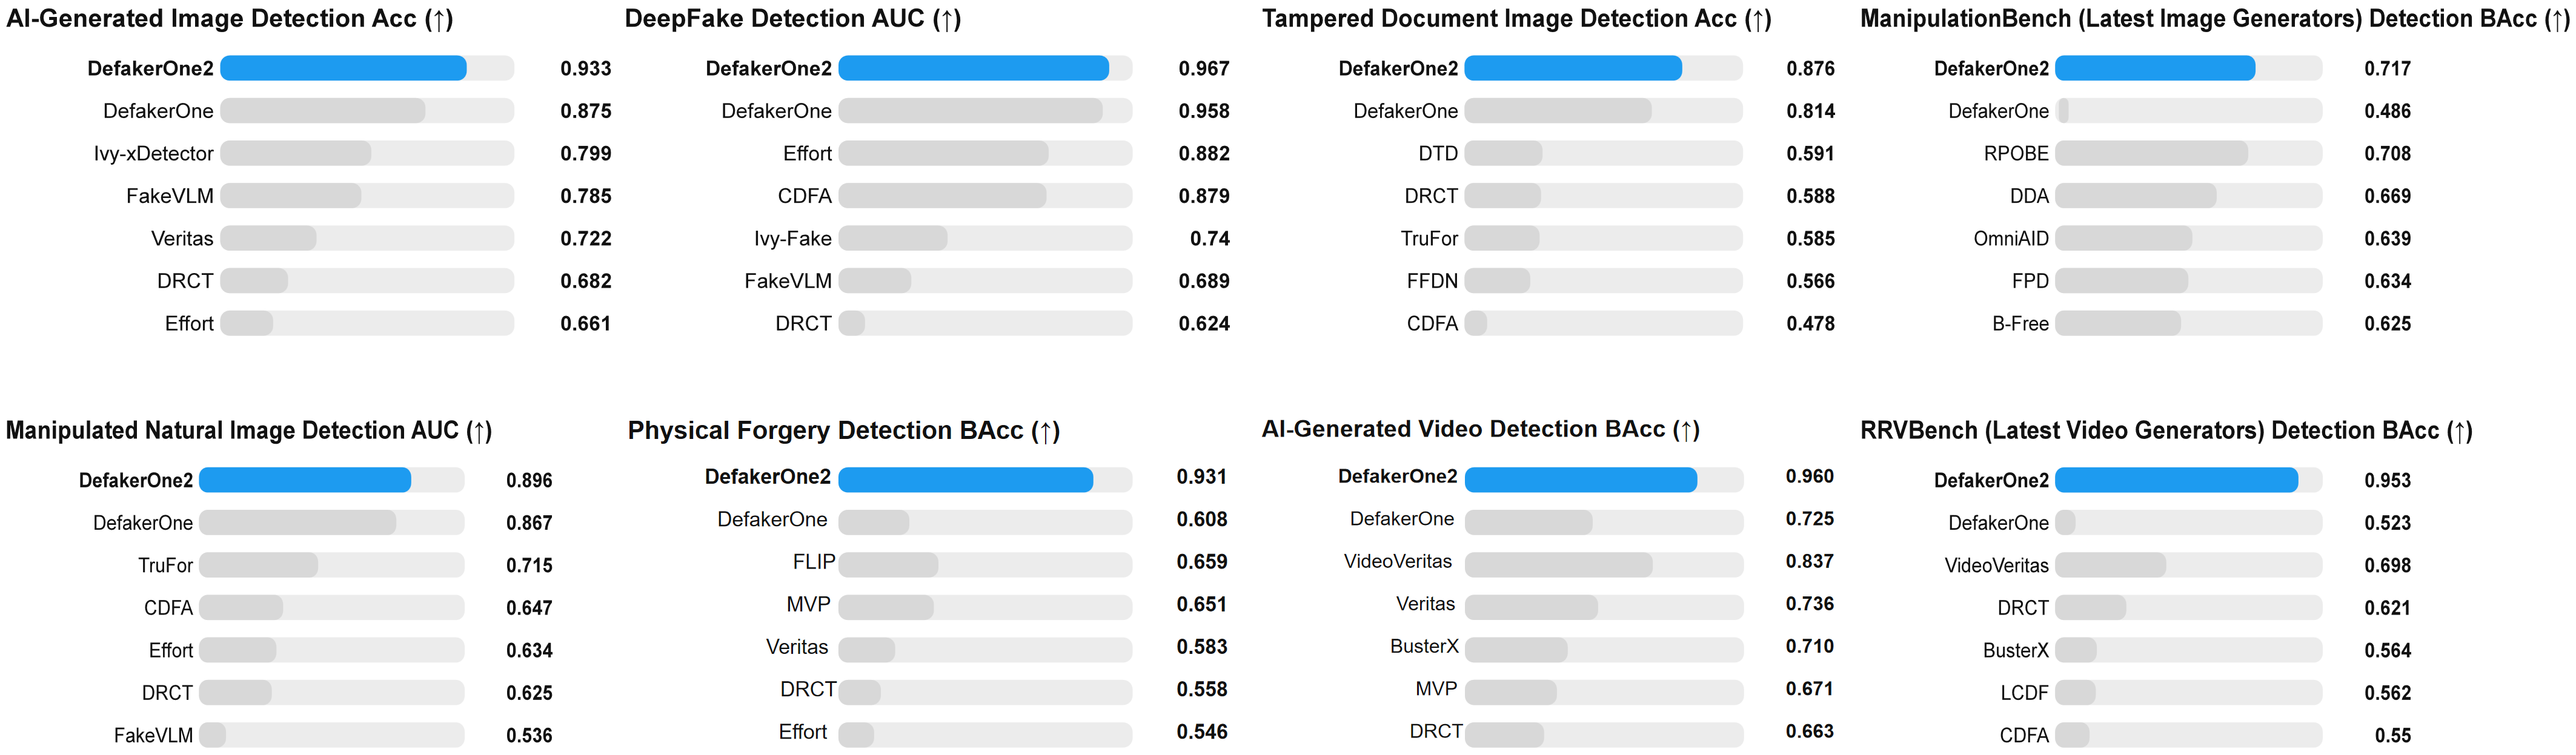
40/53 检测 SOTA,11/14 定位 SOTA

单一 2B 参数模型,在八个领域上全部排名第一。且从未在任一专家的主场上被该专家击败,跨域分差极窄——没有任何领域为这份通用性付出代价。

Table — 相比 领域专家 (SOTA)DefakerOne (V1) 在关键领域上的提升对比
领域专家 (SOTA) DeFakerOne (V1) DeFakerOne2 (Ours V2) metric: 按领域平均 · 每组自上而下为 领域专家 (SOTA) / DeFakerOne (V1) / DeFakerOne2 (Ours V2)

05 — New Benchmark

RRVBench · Realistic Rumor Video Benchmark

公开视频取证数据集里的假视频,多由一年以上发布的旧生成器合成。为跟上 AIGC 视频生成的演进速度,我们构建了 RRVBench:假视频全部由 7 个最新闭源(如SeeDance2.5)与 4 个最新开源(如MiniMaxH3)生成器合成,内容聚焦真实世界谣言场景,最大限度缩小应用鸿沟。

最新假视频生成器 ● 真实视频伪造场景

RRVBench 是视频评测中对泛化能力严苛的考验。有基线在某子集上表现尚可,却在新生成器上骤降——说明它锁定的是生成器指纹而非伪造本质。DeFakerOne2 的各子集分数相对稳定,最弱的子集仍显著高于外部方法的最佳成绩。

Figure 4 · Generated Video Samples in RRVBench
Fig. 4 — RRVBench 数据集中的伪造视频样例。RRVBench 聚焦真实谣言场景,如战争场景、政治活动、军事行动、公共事件等。

06 — Resources

论文 · 代码 · 数据

▤

Technical Report

Venus-DeFakerOne2: A Vision-Forensics Foundation Model with Broader Coverage

Paper (PDF) →
⌥

Code

推理与微调代码、模型权重发布计划

GitHub →
▣

RRVBench

1,319 真实视频 + 11 个生成器子集,含评测协议

Benchmark →
◈

Model

DeFakerOne2-2B · Qwen3.5 backbone

Weights →

BibTeX

@article{guangjian2026defakerone2,
  title   = {Venus-DeFakerOne2: A Vision-Forensics Foundation Model
             with Broader Coverage},
  author  = {Qu, Chenfan and Liang, Yachao and Fang, Mingqi and Xie, Jiangwei
             and Chang, Zheng and Wang, Zhenming and Zhang, Baoyue and
             Jin, Fanli and Jiang, Changjiang and Li, Junchi and Wang, Haoyue
             and Zhu, Xuekang and others},
  journal = {GuangJian Team, Ant Group — Technical Report},
  year    = {2026},
  note    = {\url{https://github.com/venus-guangjian/Venus-DeFakerOne2}}
}